Hindi Reels में Auto Captions कैसे लगाएं: Whisper + Claude Opus 5.5
Pawan Joshee··8 min read
Instagram Reels या YouTube Shorts पर दर्शकों को रोके रखने (audience retention) के लिए वीडियो में सटीक captions लगाना बेहद जरूरी है। लेकिन सबसे बड़ी समस्या तब आती है जब ऑटो-कैप्शन ऐप्स "Hinglish" (हिंदी और इंग्लिश का मिक्स) शब्दों या शुद्ध Devanagari स्क्रिप्ट को ठीक से समझ नहीं पाते, जिससे वीडियो में अजीब और गलत स्पेलिंग्स दिखने लगती हैं। इस सिरदर्द को दूर करने के लिए, आप OpenAI के Whisper (विशेष रूप से सुपर-फास्ट Whisper Large-v3-Turbo) और Anthropic के Claude Opus 5.5 का उपयोग करके एक बेहद सटीक और प्रोफेशनल सबटाइटल्स वर्कफ़्लो तैयार कर सकते हैं।
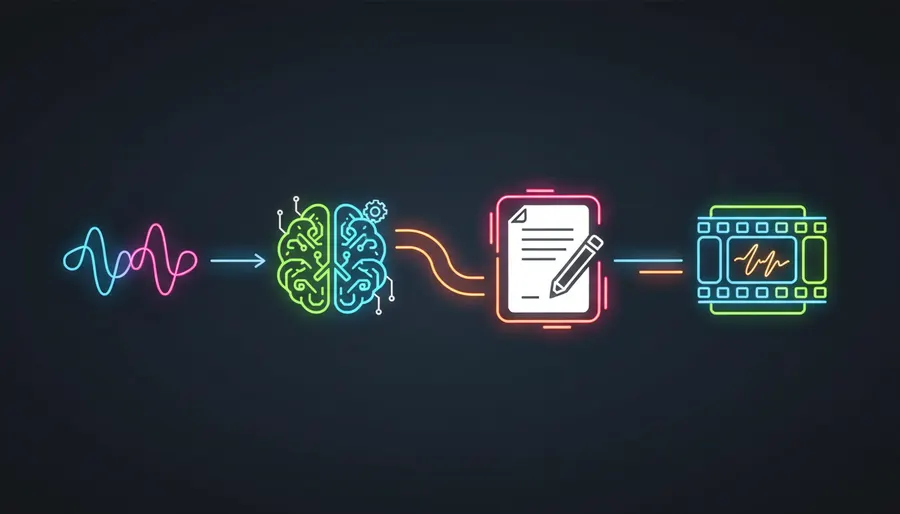
यह स्टेप-बाय-स्टेप ट्यूटोरियल आपको सिखाएगा कि कैसे अपने Reel वीडियो से ऑडियो निकालकर Whisper Large-v3-Turbo की मदद से वर्ड-लेवल टाइमस्टैम्प्स (word-level timestamps) जेनरेट करें, फिर Claude Opus 5.5 का इस्तेमाल करके स्पेलिंग और व्याकरण की गलतियों को ठीक करें, और अंत में ffmpeg या Remotion के जरिए सुंदर Devanagari फॉन्ट (जैसे Noto Sans Devanagari) के साथ कैप्शन को वीडियो में बर्न (burn) करें। चाहे आप अकेले काम करने वाले क्रिएटर हों या कोई बड़ी एजेंसी, यह तरीका आपके वीडियो को एकदम प्रोफेशनल लुक देगा।
हिंदी और Hinglish ऑटो-कैप्शन में साधारण टूल्स क्यों फेल हो जाते हैं?
मोबाइल फोन के ज्यादातर ऑटो-कैप्शन ऐप्स केवल इंग्लिश भाषा को ध्यान में रखकर बनाए जाते हैं। जब आप उनमें हिंदी या Hinglish ऑडियो डालते हैं, तो वे दो बड़ी गलतियां करते हैं:
- गलत स्पेलिंग (Phonetic Errors): उदाहरण के लिए, जब आप वीडियो में "बनाओ" बोलते हैं, तो ऐप्स उसे "banaw" या "banno" लिख देते हैं। इसी तरह, "प्रॉम्प्ट" (prompt) जैसे टेक्निकल शब्दों को वे पूरी तरह से बिगाड़ देते हैं।
- टूटे हुए देवनागरी अक्षर (Broken Devanagari): हिंदी व्याकरण में आधे अक्षरों (जैसे "क्र" या "ष्ट") का बहुत महत्व है। साधारण एडिटिंग ऐप्स के रेंडरिंग इंजन इन अक्षरों को ठीक से दिखा नहीं पाते, जिससे सबटाइटल्स देखने में बहुत खराब लगते हैं।
जब आप OpenAI के Whisper और Claude Opus 5.5 को एक साथ मिलाते हैं, तो यह समस्या हमेशा के लिए खत्म हो जाती है. Whisper आपकी आवाज की बारीक से बारीक टोन को पकड़कर सटीक शब्द जेनरेट करता है. लेकिन चूंकि Whisper के पास इंसानी समझ (context) नहीं होती, इसलिए हम Claude Opus 5.5 का इस्तेमाल करते हैं। Claude Opus 5.5 (जिसकी कीमत सिर्फ $4 प्रति मिलियन इनपुट टोकन और $20 प्रति मिलियन आउटपुट टोकन है) एक प्रोफेशनल हिंदी कॉपीएडिटर की तरह काम करता है। यह टाइमस्टैम्प को बिना छेड़े स्पेलिंग को एकदम शुद्ध देवनागरी में बदल देता है.
स्टेप 1: वीडियो से ऑडियो निकालें और Whisper Large-v3-Turbo चलाएं
सबसे पहले, आपको अपने Reel वीडियो (.mp4) से ऑडियो को अलग करना होगा ताकि ट्रांसक्रिप्शन मॉडल तेजी से काम कर सके। इसके लिए आप अपने कंप्यूटर पर ffmpeg कमांड का उपयोग कर सकते हैं:
ffmpeg -i input_reel.mp4 -q:a 0 -map a output_audio.mp3
ऑडियो फाइल (.mp3) मिलने के बाद, हम इसे Whisper मॉडल पर चलाएंगे। हम आपको Whisper Large-v3-Turbo का उपयोग करने की सलाह देते हैं. OpenAI के इस मॉडल में डिकोडर लेयर्स को 32 से घटाकर 4 कर दिया गया है, जिससे इसका पैरामीटर साइज 809 मिलियन हो जाता है. यह मॉडल साधारण Large-v3 की तुलना में 7 गुना तेजी से ऑडियो प्रोसेस करता है और इसकी सटीकता भी कमाल की है. अगर आप खुद का सिस्टम इस्तेमाल नहीं करना चाहते, तो OpenAI की Whisper API का उपयोग कर सकते हैं, जिसकी कीमत मात्र $0.006 प्रति मिनट है.
नीचे दिया गया Python स्क्रिप्ट आपके ऑडियो से वर्ड-लेवल टाइमस्टैम्प्स (word-level timestamps) जेनरेट करके एक JSON फाइल बना देगा:
import json
from faster_whisper import WhisperModel

# Load the fast Whisper Large-v3-Turbo model
model_size = 'large-v3-turbo'
model = WhisperModel(model_size, device='cuda', compute_type='float16')

# Transcribe audio with word-level timestamps
segments, info = model.transcribe('output_audio.mp3', beam_size=5, word_timestamps=True)

transcript_data = []
for segment in segments:
    for word in segment.words:
        transcript_data.append({
            'word': word.word.strip(),
            'start': round(word.start, 2),
            'end': round(word.end, 2)
        })

# Save the raw phonetic transcription to a JSON file
with open('raw_transcript.json', 'w', encoding='utf-8') as f:
    json.dump(transcript_data, f, ensure_ascii=False, indent=4)
स्टेप 2: Claude Opus 5.5 से स्पेलिंग और व्याकरण ठीक करें
Whisper से मिली JSON फाइल में केवल कच्चे शब्द और टाइमस्टैम्प होंगे। इसमें ब्रांड के नाम या इंग्लिश के शब्द सही तरीके से नहीं लिखे होंगे। इसे ठीक करने के लिए हम इस JSON डेटा को Anthropic के Claude Opus 5.5 को भेजेंगे.
Claude Opus 5.5 बेहद किफायती है (कीमत: $4/M input और $20/M output) और इसकी एडवांस्ड रीजनिंग क्षमता इसे जटिल Hinglish वाक्यों को समझने और उन्हें शुद्ध देवनागरी लिपि में बदलने में सक्षम बनाती है, वो भी बिना टाइमस्टैम्प में कोई बदलाव किए.
इस प्रॉम्प्ट को कॉपी करें और अपनी JSON फाइल के साथ Claude Opus 5.5 में पेस्ट करें:
You are an expert Hindi and Hinglish copyeditor. Your job is to take a raw JSON file containing word-level timestamps from a Whisper transcription and correct the text inside it.

Follow these strict rules:
1. Do NOT modify the 'start' or 'end' timestamps under any circumstances.
2. Correct the 'word' field. Whisper often makes phonetic errors in Hinglish (e.g., transcribing 'banao' as 'banaw' or 'प्रॉम्प्ट' as 'promt').
3. Convert the words into clean, natural Devanagari script (or keep it in clean Hinglish if requested, but Devanagari is preferred for Hindi reels).
4. Ensure correct spelling of technical terms (e.g., AI, Instagram, Reel, Claude, Whisper).
5. Output ONLY the valid corrected JSON array. Do not include any conversational filler, markdown formatting outside the code block, or explanations.

Input JSON:
[YOUR_RAW_JSON_HERE]
Claude आपको तुरंत एक सुधरा हुआ JSON डेटा वापस कर देगा, जिसमें सभी हिंदी शब्द सही और स्पष्ट देवनागरी में लिखे होंगे.
स्टेप 3: सही देवनागरी फॉन्ट का चुनाव करें
यदि आप चाहते हैं कि आपके रील के कैप्शन इंस्टाग्राम पर सुंदर दिखें, तो सही फॉन्ट का उपयोग करना सबसे महत्वपूर्ण कदम है। Arial या Helvetica जैसे साधारण फॉन्ट हिंदी के आधे अक्षरों (conjuncts) को सपोर्ट नहीं करते, जिससे अक्षर आपस में चिपक जाते हैं या अजीब डिब्बे दिखाई देने लगते हैं।
प्रोफेशनल लुक के लिए आप Google Fonts से ये दो मुफ्त फॉन्ट डाउनलोड कर सकते हैं:
- Noto Sans Devanagari: यह फॉन्ट बहुत ही साफ और आधुनिक है। मोबाइल स्क्रीन पर इसे पढ़ना बेहद आसान होता है।
- Hind: यह थोड़ा गोल और बोल्ड फॉन्ट है। कई बड़े भारतीय क्रिएटर्स अपनी रील्स में इस फॉन्ट का इस्तेमाल करते हैं ताकि कैप्शन आकर्षक दिखें।
इन फॉन्ट्स की .ttf फाइल को अपने कंप्यूटर में इंस्टॉल कर लें ताकि रेंडरिंग के समय कोई समस्या न आए।
स्टेप 4: वीडियो में कैप्शन बर्न करें (ffmpeg और Remotion)
Claude से सुधारे गए JSON को सबटाइटल्स फाइल (.srt) में बदलें। इसके बाद, आपको इन सबटाइटल्स को वीडियो में स्थायी रूप से बर्न (hardcode) करना होगा ताकि दर्शकों को बिना किसी बटन को दबाए सीधे कैप्शन दिखाई दें।
यदि आप कमांड लाइन का उपयोग करना पसंद करते हैं, तो ffmpeg का यह कमांड आपके लिए सबसे बेस्ट है। यह कमांड कैप्शन को पीला रंग देगा और पीछे एक साफ काला बॉर्डर जोड़ देगा:
ffmpeg -i input_reel.mp4 -vf "subtitles=captions.srt:force_style='FontName=Noto Sans Devanagari,FontSize=16,PrimaryColour=&H00FFFF&,OutlineColour=&H000000&,BorderStyle=3'" -c:a copy output_reel.mp4
यदि आप एक डेवलपर या एजेंसी हैं और इस पूरी प्रक्रिया को पूरी तरह से ऑटोमैटिक करना चाहते हैं, तो Remotion (एक React-आधारित फ्रेमवर्क) सबसे बढ़िया विकल्प है। इसकी मदद से आप CSS और वेब फॉन्ट्स का उपयोग करके CapCut की तरह हिलने-डुलने वाले और एनिमेटेड वर्ड-बाय-वर्ड कैप्शन प्रोग्रामिंग के जरिए बना सकते हैं।
कैप्शन रेंडर करने के अलग-अलग तरीकों की तुलना नीचे दी गई है:
| फीचर | ffmpeg | Remotion | CapCut / मोबाइल ऐप्स |
|---|---|---|---|
| ऑटोमेशन | पूरी तरह ऑटोमैटिक (कमांड लाइन) | पूरी तरह ऑटोमैटिक (React कोड) | मैनुअल / आधा ऑटोमैटिक |
| डिजाइन और स्टाइल | बेसिक स्टाइलिंग | असीमित (CSS और React एनिमेशन) | टेम्पलेट-आधारित |
| प्रोसेसिंग स्पीड | बेहद तेज | सामान्य (रेंडरिंग में समय लगता है) | तेज (डिवाइस पर रेंडर होता है) |
| हिंदी फॉन्ट सटीकता | बेहतरीन (सही फॉन्ट के साथ) | बेहतरीन (वेब फॉन्ट के साथ) | खराब (अक्सर अक्षर टूट जाते हैं) |
| खर्च | पूरी तरह मुफ्त और ओपन-सोर्स | मुफ्त (सेल्फ-होस्टेड) | मुफ्त / पेड सब्सक्रिप्शन |
स्टेप 5: प्रूफरीडिंग (Proofreading) है सबसे जरूरी
भले ही Whisper Large-v3-Turbo और Claude Opus 5.5 मिलकर 95% से ज्यादा सटीकता देते हैं, लेकिन AI कभी भी 100% परफेक्ट नहीं हो सकता। कई बार कुछ स्थानीय स्लैंग (स्थानीय भाषा के शब्द), ब्रांड के नाम या आपके बोलने के खास अंदाज को AI गलत समझ सकता है।
इसलिए, इंस्टाग्राम पर अपनी रील पोस्ट करने से पहले हमेशा 2 मिनट निकालकर वीडियो को ध्यान से देखें। यह सुनिश्चित करें कि जो शब्द बोला जा रहा है, स्क्रीन पर वही देवनागरी में सही-सही दिख रहा है या नहीं। यह छोटी सी मेहनत आपके वीडियो की क्वालिटी को काफी बढ़ा देगी।
FAQ
ffmpeg में हिंदी के अक्षर टूटे हुए या बॉक्स के रूप में क्यों दिखते हैं?
यह तब होता है जब ffmpeg को आपके सिस्टम में देवनागरी फॉन्ट नहीं मिलता या वह किसी ऐसे फॉन्ट का उपयोग करता है जो हिंदी को सपोर्ट नहीं करता। हमेशा सुनिश्चित करें कि आपने "Noto Sans Devanagari" या "Hind" फॉन्ट डाउनलोड किया है और अपने कमांड में उसका सही नाम लिखा है।
इस Whisper + Claude वाले तरीके में कितना खर्च आता है?
यह तरीका बहुत ही सस्ता है। OpenAI की Whisper API की कीमत केवल $0.006 प्रति मिनट है। वहीं Anthropic के Claude Opus 5.5 की कीमत $4 प्रति मिलियन इनपुट टोकन और $20 प्रति मिलियन आउटपुट टोकन है। यानी एक रील के कैप्शन ठीक करने में आपको मात्र कुछ पैसे ही खर्च करने होंगे।
क्या मैं यह पूरा काम अपने मोबाइल फोन पर कर सकता हूँ?
हालांकि Whisper और Claude को चलाने के लिए कंप्यूटर या API की जरूरत होती है, लेकिन आप मोबाइल पर Python चलाने वाले ऐप्स (जैसे iOS पर Carnets) का इस्तेमाल कर सकते हैं। लेकिन वीडियो रेंडर करने और ffmpeg चलाने के लिए लैपटॉप या कंप्यूटर का उपयोग करना ही सबसे बेहतर और तेज तरीका है।
क्या मैं Claude Opus 5.5 की जगह Claude 3.5 Sonnet का इस्तेमाल कर सकता हूँ?
Sonnet या Haiku जैसे सस्ते Claude models की कीमत Opus से कम होती है और ट्रांसक्रिप्ट सफाई या बेसिक React कोड जैसे आसान कामों के लिए काफी हैं — मौजूदा रेट Anthropic की pricing page पर चेक करें।